基础设施:让用户用得上,出问题能恢复
本篇内容
你终于约到一位愿意试用的人。首页打开很快,演示视频也能播放,但他选择表格、点下生成后,一直等不到结果。你从国内电脑再试一遍,却没有复现。此时,“网站已经部署成功”帮不上多少忙:到底是页面、请求、数据,还是某个只有你知道的前提出了问题?
基础设施要解决的,就是让一次使用可以完成,也可以被你解释和恢复。先沿着用户的任务看需要什么,再选工具,会比从一张热门服务清单开始更容易作决定。
本章继续使用周报工具的教学案例:第一轮试用在浏览器里处理文件,不上传、不保存云端历史。后面需要账号与服务端状态的情形是另一个阶段。文中的延迟数字为合成设定;发布与恢复部分则附有本次实际执行的本地隔离演练,不代表海外生产环境已经验收。
先决定,哪些东西现在就需要存在
试用者当前要做的事很具体:打开英文说明,用虚构样例看懂结果,再用自己的表格生成并导出草稿。只要这条路径都在浏览器里完成,就可以先交付一个有域名、有版本记录的静态站点。账号、数据库和登录邮件暂时不在关键路径上。
这能减少初次体验的等待,也减少你要保管的状态。但代价同样明确:没有跨设备历史,刷新或关闭页面前需要导出;不能依靠前端代码保管秘密,也不能把隐藏按钮当成付费授权。若客户真正需要共享报告、保存历史或购买后恢复权益,就要为那些状态增加后端,而不是继续假装所有问题都能留在浏览器里。
中文开发者程小白在 2022 年复盘博客迁移时,遇到的麻烦并不是算力不足。他维护过内容和图片的副本,更新后各处缓存会短暂不一致;同时,构建依赖和手动上传也耗费精力。结合自己的访问情况,他最终取消分流,将数量不多的图片转成 WebP 随仓库管理,收拢到 GitHub 与 Cloudflare Pages 的发布流程。[1]
值得借鉴的是这次减法的依据:内容是静态的,图片规模小,额外副本没有带来足够收益。这不能直接替有账号、订单和用户文件的产品选架构。回到我们的试用样稿,先把页面、脚本和样例作为一个可重复构建的版本交付,确实比先接五个服务更符合当前任务。
同一个产品,两个不同阶段
当前:完成一次本地试用
- 域名与页面
交付固定版本 - 浏览器处理
文件留在本机 - 导出草稿
用户保存结果
↓ 当保存、共享或权益成为必要能力时,再增加下方路径
有服务端状态以后
- 浏览器发出请求
身份与具体动作 - API + 数据存储
授权、记录、恢复 - 返回结果
必要时另发通知
如果进入第二阶段,我会在这个案例里先选一个容易部署、能导出数据的托管后端,并让它与主要数据库靠近。理由是维护者只有业余时间,还没有证明自己需要多地写入或特殊运行环境。托管也有边界:运行限制、数据导出、备份范围和账户恢复,都要在交付前走一次,不能因控制台显示绿色就略过。
自管 VPS 并非天然更差。已经熟悉系统更新、日志、数据库和恢复的人,可以把一个小服务放在自己掌握的环境里;但本例尚未具备这项运维条件,不能只比较月账单就把维护工作算成免费。相反,全球多个后端和多套数据副本现在更难解释:还没有实测瓶颈,却先增加了故障时要核对的状态。出现目标地区的真实延迟或可用性问题,再决定扩在哪里。
页面很快,为什么生成结果仍然很慢
静态资源离用户近,和处理任务的代码离数据库近,是两个不同问题。一个页面可以很快从缓存加载,随后发出的动态请求却连续跨很远的距离读取数据。此时只测首页,恰好绕开了用户真正等待的部分。
Cloudflare 的 Placement 文档就用多次后端往返解释这类取舍:Workers 默认靠近接收请求的位置运行,但访问数据库等后端时,让代码靠近后端可能更快。它支持的是“沿请求路径看位置”的判断,不是某个节点对所有产品都最快的保证。[2]
下面给同一请求安排两条路径。假设它依次查询四次,每次必须等上一次返回,不能并行;数字只计算网络往返,不含查询执行、连接建立、传输大文件或缓存差异。改变次数和距离,看看哪一段开始支配等待。
动手比较 · 合成网络条件
代码应该靠近用户,还是靠近数据?
A · API 靠近用户
- 浏览器
- 近用户 API
与浏览器往返 20 毫秒 - 远端数据库
4 次往返,每次 150 毫秒
620 毫秒网络等待
20 + 4 × 150 = 620
B · API 靠近数据库
- 浏览器
- 近数据 API
与浏览器往返 160 毫秒 - 同处附近的数据库
4 次往返,每次 5 毫秒
180 毫秒网络等待
160 + 4 × 5 = 180
这组设定下,B 少等待 440 毫秒。减少反复跨距离查询,比缩短最初那一次连接更有影响。
这是两条假设路径的比较,不是地区测速或供应商排名。真实决定还要考虑执行时间、读写一致性、数据所在地与目标用户的实际网络。
因此,有状态版本的第一份位置决定可以很朴素:静态页面单独交付;把完成一次动态任务的代码和主要数据放在容易连通的位置;先减少不必要的串行读取。再从目标用户的真实环境测完整操作,确认结果,而不是把地图上的国家名称当性能数据。
验收时让同一份小样本从头走完:新会话打开页面,生成 North 项目的 5 小时草稿,导出并重新打开文件。随后用一份缺少必填列的样本,看错误能否被理解。记录发生时间、所用版本、失败步骤和请求标识;不要把客户原文件放进排障记录。若加入账号或收费,再增加登录、关闭后重新进入、权益读取等路径,支付事件的一致性见收款方案全景。
这里需要两种视角:用户所在的网络能否完成任务,维护者平时的网络能否发布、查看告警并联系服务商。两边都能打开首页,仍不足以证明上述过程走通。本轮只完成了本地隔离演练,目标用户环境的这一步需要在真实试用时补做。
邮件已经发了,用户为什么还进不来
一旦登录依赖邮件,邮箱就进入了产品的关键路径。对用户来说,他只知道“没有收到”;对你来说,至少要分清请求是否被接受、收件服务器是否接收,以及用户最后有没有完成登录。
以 Resend 的事件定义为例,email.sent 表示 API 请求成功,之后仍会尝试投递;email.delivered 表示送达收件方邮件服务器。后一个状态并没有告诉你邮件位于主收件箱,也没有证明登录链接有效。临时投递延迟与永久退信还有各自的事件。[3]
从发件记录走到一次成功登录
- 请求被接受保存消息 ID,确认发件环境、模板和收件地址。未接受 → 查密钥、发件域与请求错误。
- 收件服务器接收按同一个消息 ID 查 delivered、延迟或退信。未接收 → 依据实际事件处理,避免盲目重复发送。
- 用户完成登录用测试收件箱实际打开链接,确认正确域名、有效期和回跳页面。已经接收但未完成 → 继续查邮箱位置、地址拼写和链接流程。
截至 2026-10-09,Gmail 对个人 Gmail 收件账号的发件要求仍区分一般和批量发送者:一般发送者至少配置 SPF 或 DKIM;批量发送者要求 SPF、DKIM 和 DMARC,营销和订阅邮件还有一键退订要求。Google 建议所有发送者配置三项认证。按发件服务提供的记录配置,再用实际收件验收,不把某一个邮箱提供商的规则概括成所有邮箱都相同。[4]
假设测试记录中,demo-mail-01 的 API 请求成功,随后出现 email.delivery_delayed,用户没有登录。此时可确认的是消息还没有完成服务器投递;没有证据说验证码页面坏了。先查看具体延迟原因,在页面保留清楚的等待与重试入口,并限制重复请求。若后来变成 delivered,再去核对实际收件和链接,排查顺序也随证据改变。这是事件解释示例,没有真实发件结果。
给用户的文字也应和证据一致。可以写 “We’ve requested a sign-in email. It may take a moment to arrive.”,而不是在 API 返回成功时就宣布邮件已经进入收件箱。重要故障的告警也不要只依赖正在排查的那一条邮件路径。
恢复旧版本,和找回用户的工作,是两回事
GitLab 在 2017 年的数据库事故中,先是主库数据被误删,随后发现预期中的备份并不可用。原始复盘记录:备份工具与数据库主版本不匹配,导出任务失败;通知失败的邮件又被拒收,问题没有及时暴露。最终团队使用约六小时前为测试准备的快照恢复,之后一段时间的修改仍然丢失。[5]
这个案例值得看的不是“连大公司都会出错”,而是几个各自看似存在的保护为什么没有接起来:有备份任务,却没有可用产物;有告警配置,却没有收到告警;有旧数据,却没有最近的工作。小产品不需要复制当年的系统规模,但需要把这三件事分别验证。
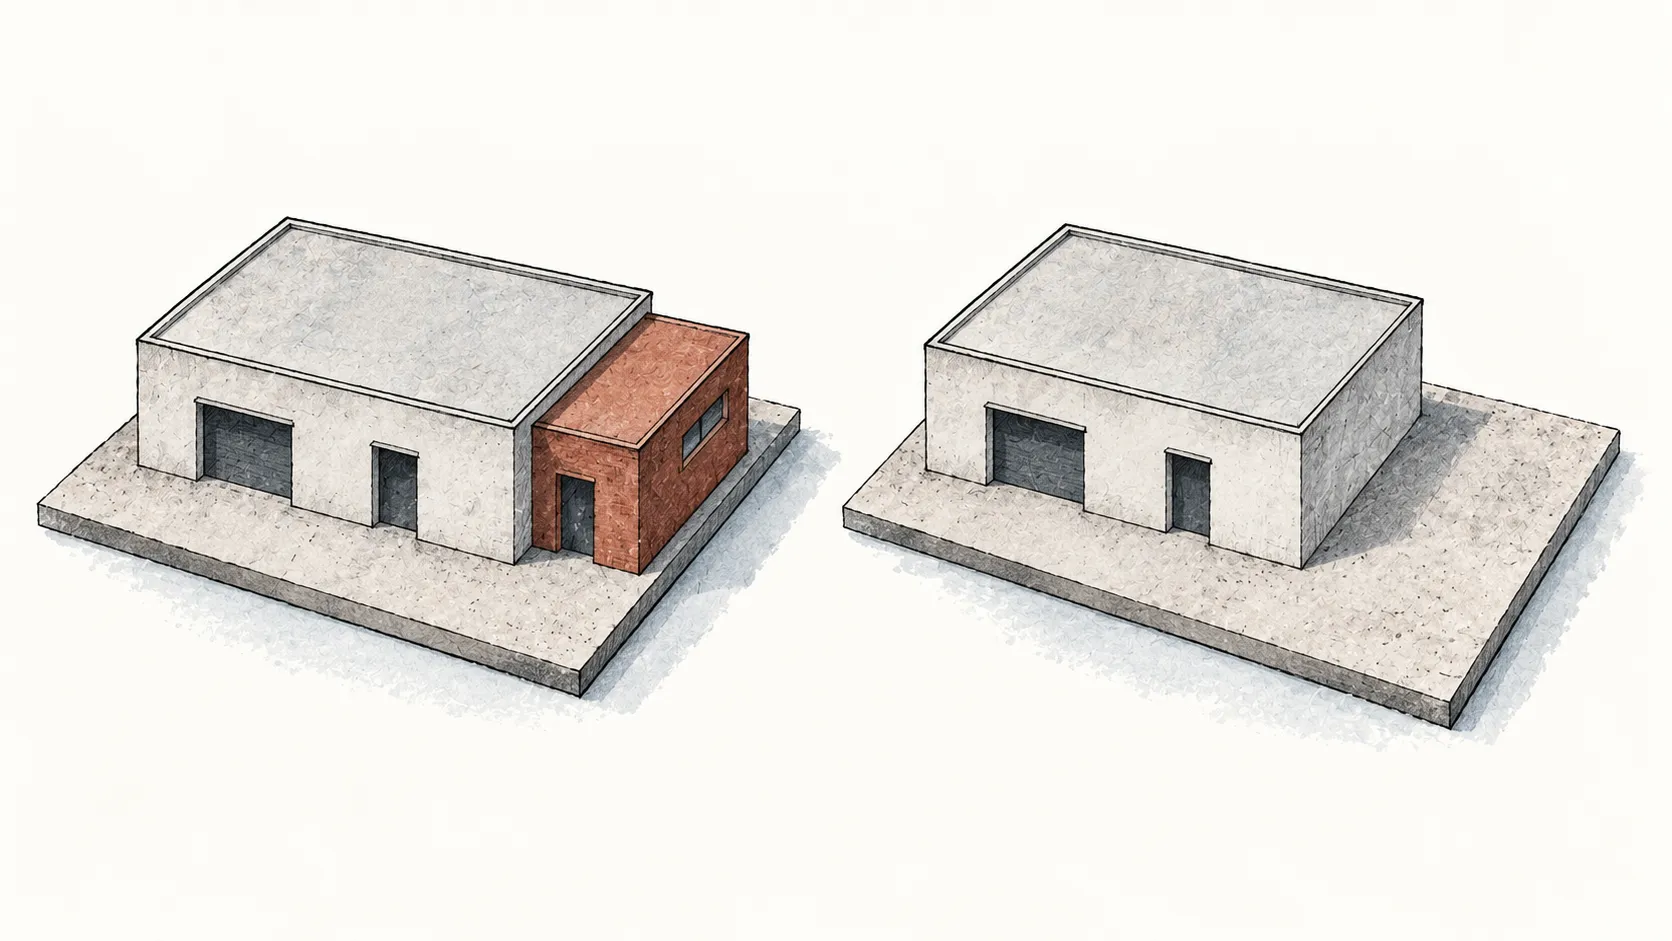
就像保留原建筑的模型不含后来加建的部分,能打开的旧副本也可能缺少新工作。恢复后还要核对缺了什么。
一次实际执行的隔离演练
我们为这一章写了一个只在本机运行的练习:两个版本的微型 HTTP 服务,加一份合成 JSON 记录。2026-10-09,在 macOS、Node.js 22.19.0 下实际执行了下面的过程。所有故障只发生在脚本新建的临时目录里,没有连接真实数据库、云平台或客户数据。
North 项目最初有两条记录:Research 为 3 小时,Draft report 为 2 小时。v1 正确求和;故意写错的 v2 只取第一行。恢复部分再增加一条 Review,值为 1 小时,用来观察备份之后的工作。
| 实际执行的动作 | 观察到的结果 | 这一关说明什么 |
|---|---|---|
启动 v1,请求 /report | HTTP 200,5 小时 | 已有一份可核对的基准 |
停止旧服务,启动故意出错的 v2 | 健康入口正常,报告 HTTP 200,却只有 3 小时 | 只监测状态码会漏过结果错误 |
停 v2,重新启动 v1 | 回到 5 小时 | 这次代码回退有效,数据格式没有改变 |
停写并复制备份,再新增 r3 | 新记录被读出,总计 6 小时 | 备份之后出现了新工作 |
损坏练习数据,再运行原来的 v1 | HTTP 500,记录无法读取 | 正确的代码不能修复坏数据 |
将旧备份复制到隔离目录并启动 v1 | HTTP 200,5 小时,缺少 r3 | 旧副本可读,最新工作尚未完整恢复 |
最后一步刻意没有记成“恢复成功”:它通过的是旧备份可读检查,未通过的是最新业务记录完整性检查。必须从仍然可用的其他记录补齐,或明确说明丢失范围;不能因为页面重新变绿,就告诉用户所有内容都回来了。
你可以下载 完整演练脚本,在装有 Node.js 22 或更新版本的本机执行:
node infrastructure-drill.mjs脚本仅监听 127.0.0.1 的临时端口,输出每一步的 HTTP 结果和校验结论,在新建临时目录留下 result.json,最后关闭服务。这是文件与进程层面的教学演练:复制前已停止写入,不能把它的 JSON 文件复制方法照搬成运行中数据库的备份方案,也没有测量真实故障下的恢复时间。
从练习接到自己的服务
真正上线时,先明确分别要恢复什么。页面和程序需要可重新构建的版本;数据库需要受支持的备份与恢复方式;对象文件、环境配置、密钥以及第三方状态还要逐项覆盖。以 Supabase 为例,其文档明确数据库备份不包含 Storage 里的对象文件,数据库只保存相关元数据;恢复旧数据库备份不会找回后来删除的对象。托管备份有用,但名字叫“数据库备份”就不该被理解为“整个产品副本”。[6]
恢复时,先分清哪里出了问题
暂停受影响的写入,保留当前状态与诊断记录
代码结果错,数据仍完整
确认旧版本能读当前数据 → 回退版本 → 重跑固定样本。
做过数据迁移时,必须另查兼容性。数据损坏或丢失
选恢复点 → 在隔离环境恢复 → 比较记录与文件 → 说明缺口。
旧副本之后发生了什么,需要另找证据。↓ 两条路径都要回到真实任务:能打开、算正确、记录齐,再决定恢复服务
然后给恢复目标写上能检查的边界。比如这次练习可以准确报告“恢复到备份中的两条记录,第三条缺失”,却不能报告“零数据丢失”。自己的服务也应写清最多能接受回到多早的状态,以及准备在多长时间内恢复关键操作;这两个目标分别决定备份间隔和恢复准备,不能从云厂商的可用性数字直接推出来。
发布过程与此相接:为每次构建留下代码版本、配置环境和固定样本结果;先在隔离环境验证,再开放给用户。上线后重复同一个小任务,既检查可达,也检查输出。若正在处理真实付款或发信,演练环境应关闭这些外部动作,不能让一次恢复测试给客户补发旧通知。
把恢复入口留在故障之外
应用还在,域名过期或管理邮箱失效,也会让你无法继续服务。以 Cloudflare Registrar 为例,官方写明默认开启自动续费;默认值不能证明付款方式一直有效,仍要查看实际续费结果。保留域名、DNS 和邮件记录的当前配置,恢复邮箱尽量不要只依赖同一个域名。[7]
对本例,可以把恢复所需资料整理成一个单独保存的小包:当前发布版本、上一可用版本、构建步骤、DNS 记录、备份所在位置、恢复操作说明,以及一份没有客户资料的固定测试样本。写清密钥存放在哪里,不把密钥本身塞进仓库或这份说明。至少从新目录做一次构建和恢复,查出自己平时电脑上那些没有记录的依赖。
密钥与环境也要分开。Cloudflare Workers 文档要求敏感值使用 secrets,不能放进明文 vars;本地 .dev.vars、.env 不应提交到 Git,不同环境需要按其加载和配置规则分别处理。对使用其他平台的服务,同样要核对其实际机制。[8]
一个实用的发布前检查,是把环境、回跳域名、数据存储、支付模式和发件地址放在一起核对。测试邮件跳回正式站,或者测试支付写进正式权益库,单看其中一个服务的配置都可能“没有报错”。发现泄露时需要撤销或轮换凭据,不能只删除眼前文件;账户恢复细节见风控与账户安全。
服务进入中国境内业务时,还要核对什么?
技术位置不能代替业务范围判断。本轮读取的《互联网信息服务管理办法》为 2024 年修订文本,其第二至四条规定境内互联网信息服务的适用范围,以及经营性许可、非经营性备案的区分。2026 年 7 月 3 日网信办公布的另一份文本仍标为修订草案征求意见稿,不能把该草案直接当作已经生效的手续。[9][10]
把真实经营主体、服务内容、面向地区、服务器与网络资源所在地、收费方式和分发渠道一并交给住所地通信管理部门与接入服务商,核对适用事项。对本例,询问至少应说明:“大陆个人提供浏览器内处理表格的 Web 工具,不上传客户文件;拟使用的托管地区与网络资源为已确认的具体配置,预期用户及分发范围为已确认的实际地区。若增加国内分发、账号或收费,分别需要哪些许可、备案或材料?”没有确定的信息先列出,别用“出海”两个字补齐它。
若还有 App,工信部通知针对在境内从事互联网信息服务的 APP 主办者要求备案,已有网站备案的也需补充 APP 信息。具体分发路径见应用商店路线,数据处理与跨境问题见合规底线。[11]
做到这里,你应该能拿出几样互相对应的东西:当前用户路径、每次发布的版本和样本结果、真正恢复过的副本,以及还没有覆盖的缺口。对于本章的初轮试用,先把浏览器内生成与导出交付稳定;当账号、保存或收费成为必要能力,再沿新的关键路径补验证。若加入模型调用或向客户开放接口,继续用 AI、API 与插件专项 检查任务、额度和失败恢复。下一步的定价与订阅,也需要把这些服务与支持成本算进承诺里。
实践案例采用原作者复盘;本地演练只证明所列环境和合成故障下的结果。目标用户网络、真实邮件和生产恢复尚未实测。
Sources
- 开发者的窘境 · 程小白 · accessed
- Placement · Cloudflare Workers Docs · accessed · archive
- Event Types · Resend · accessed
- Email sender guidelines · Google Gmail Help · accessed
- Postmortem of database outage of January 31 · GitLab · accessed
- Database Backups · Supabase Docs · accessed
- Cloudflare Registrar · Cloudflare Docs · accessed
- Secrets · Cloudflare Workers Docs · accessed
- 互联网信息服务管理办法(2024年修订文本) · 国家药品监督管理局 · 国务院法规转载 · accessed
- 关于《互联网信息服务管理办法(修订草案征求意见稿)》再次公开征求意见的通知 · 国家互联网信息办公室 · accessed
- 工业和信息化部关于开展移动互联网应用程序备案工作的通知 · 工业和信息化部 · 湖南省人民政府转载 · accessed
划线与讨论
反馈入口尚未开放。开放后,你可以选中文章中的一段文字,说明有误、过期或没看懂的地方。